Τεχνητή Νοημοσύνη – Νέα & Εργαλεία | Greek AI Network

Greek AI Network

  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI
No Result
View All Result
Τεχνητή Νοημοσύνη – Νέα & Εργαλεία | Greek AI Network

Greek AI Network

No Result
View All Result
Home Νέα

AMD MI300X: καλύτερη απόδοση LLM με διαχωρισμένο serving

by Theodoros Kostogiannis
30 Μαΐου, 2026
in Νέα
0
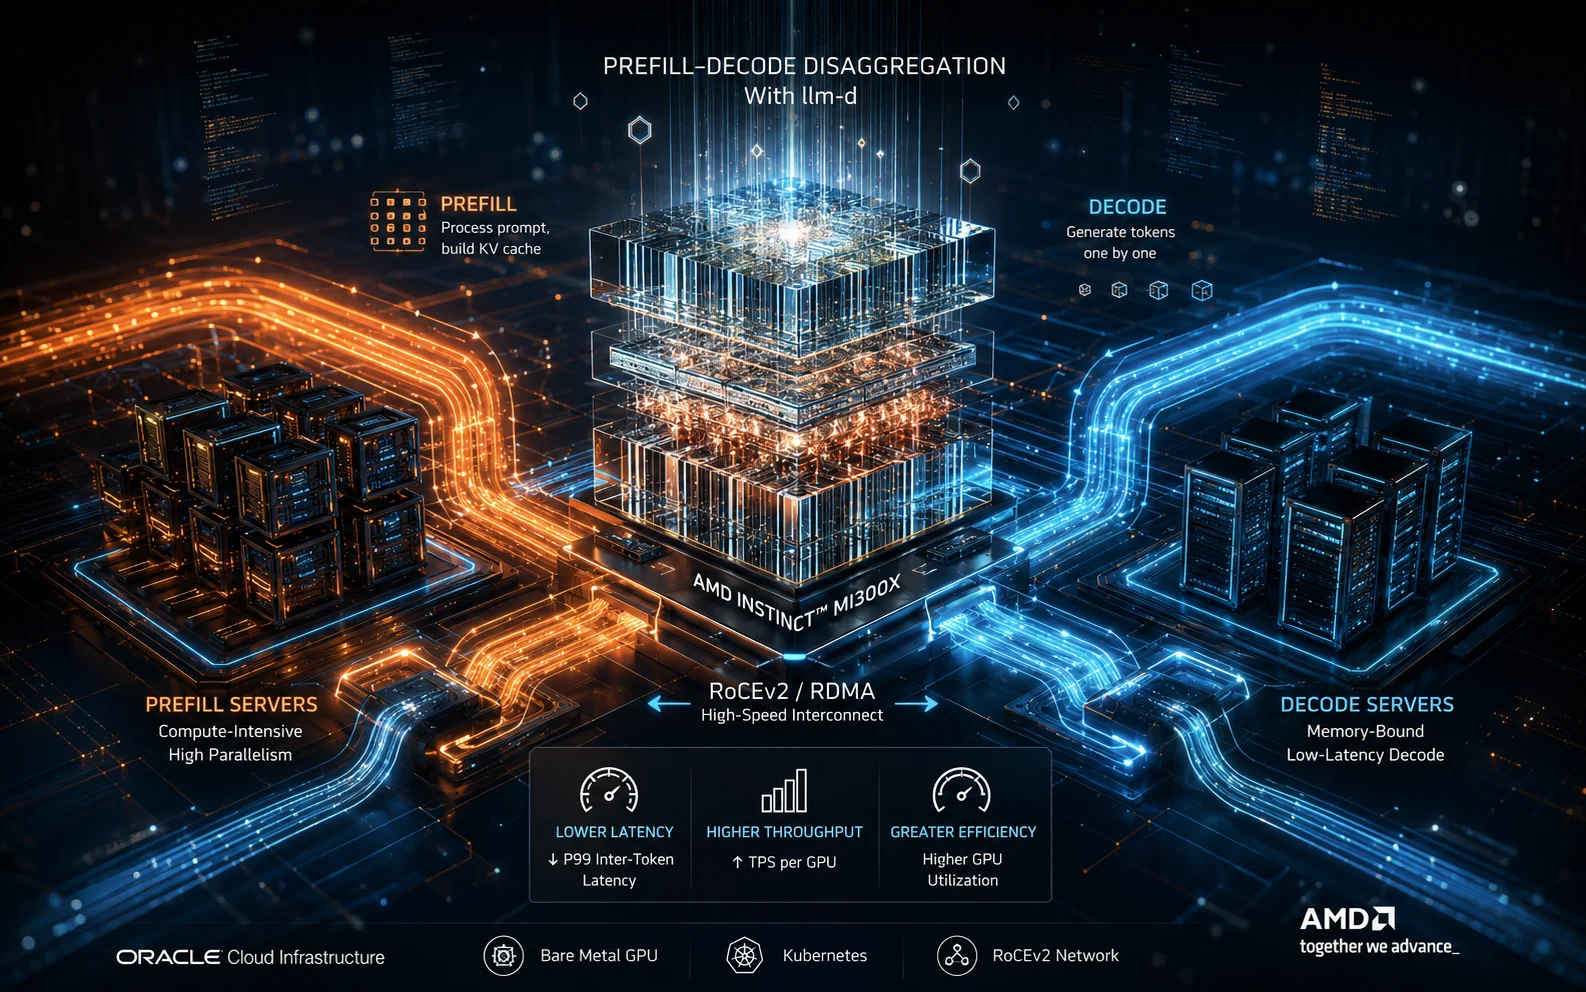
Διάγραμμα απόδοσης LLM serving με prefill-decode disaggregation σε AMD Instinct MI300X GPUs στο Oracle Cloud Infrastructure, συγκρίνοντας aggregated και disaggregated deployments ως προς latency, throughput και GPU efficiency.
Share on FacebookShare on Twitter

Εισαγωγή: Βελτιστοποίηση της Εξυπηρέτησης Παραγωγής LLM με Διαχωρισμό Προκαταβολής-Αποκωδικοποίησης

Η εξυπηρέτηση παραγωγής των μεγάλων γλωσσικών μοντέλων (LLM) αποτελεί τελικά ένα πρόβλημα βελτιστοποίησης των στόχων επιπέδου υπηρεσίας (SLO). Οι ομάδες δεν επιδιώκουν απλώς να μεγιστοποιήσουν την ακατέργαστη απόδοση, αλλά να επιτύχουν τους σωστούς στόχους καθυστέρησης και απόκρισης με το χαμηλότερο δυνατό κόστος υποδομής. Η διαχωρισμένη εξυπηρέτηση προκαταβολής-αποκωδικοποίησης με το llm-d1 προσφέρει έναν ισχυρό τρόπο για να επιτευχθεί αυτό, αλλά η αξιοποίηση των πλεονεκτημάτων της απαιτεί μια πειθαρχημένη προσέγγιση για την αναγνώριση της σωστής διαμόρφωσης για ένα συγκεκριμένο μοντέλο, φόρτο εργασίας και στόχο υπηρεσίας. Σε αυτό το άρθρο, παρουσιάζεται μια πρακτική μεθοδολογία για τη ρύθμιση της διαχωρισμένης εξυπηρέτησης PD, ώστε να επιτευχθούν οι στόχοι SLO με αποδοτικό τρόπο σε GPU AMD Instinct™ MI300X που φιλοξενούνται σε bare-metal GPU της OCI με δίκτυο RDMA πίσω από το RoCEv2.

Ξεκινάμε με την ανεξάρτητη αξιολόγηση των κύριων φάσεων της παραγωγής: αποκωδικοποίηση, προκαταβολή και συνολική εξυπηρέτηση. Με την απομόνωση αυτών των συμπεριφορών, οι επαγγελματίες μπορούν να κατανοήσουν καλύτερα το φάσμα απόδοσης κάθε σταδίου και να εντοπίσουν διαμορφώσεις υποψηφίων που ταιριάζουν καλά στο προφίλ υπολογισμού του μοντέλου. Αντί να μαντεύουν το σχήμα του συμπλέγματος ή τις αναλογίες πόρων, αυτό παρέχει ένα θεμελιωμένο σημείο εκκίνησης για την επιλογή διαμόρφωσης.

Ανάλυση και Αξιολόγηση των Υποψηφίων Διαμορφώσεων

Από εκεί, πραγματοποιούμε μια ανάλυση Pareto σε υποψήφιες διαμορφώσεις για να αξιολογήσουμε τις ανταλλαγές μεταξύ καθυστέρησης, ταυτόχρονης εκτέλεσης και αποδοτικότητας. Αυτό καθιστά δυνατή την αναγνώριση των βέλτιστων διαμορφώσεων σε διαφορετικά επίπεδα φόρτου και πού τα οφέλη του διαχωρισμού γίνονται πιο εμφανή. Αντί για μια μοναδική “καλύτερη” διαμόρφωση, το αποτέλεσμα είναι ένα πλαίσιο απόφασης: ποια διαμόρφωση PD έχει νόημα για έναν δεδομένο στόχο ταυτόχρονης εκτέλεσης και απαίτηση SLO.

Τέλος, επικυρώνουμε την επιλεγμένη διαμόρφωση με μια εκτέλεση κλίμακας, δείχνοντας πώς η μεθοδολογία επεκτείνεται από την αξιολόγηση ενός σταδίου σε μια ρεαλιστική κατανεμημένη ανάπτυξη. Το αποτέλεσμα είναι μια επαναλαμβανόμενη διαδικασία για τη μετάβαση από δεδομένα μικροαξιολόγησης σε αρχιτεκτονική εξυπηρέτησης έτοιμη για παραγωγή, βοηθώντας τελικά τις ομάδες να χρησιμοποιήσουν το llm-d για να επιτύχουν τους στόχους SLO με την πιο αποδοτική διαμόρφωση προκαταβολής-αποκωδικοποίησης.

Πώς να Διαμορφώσετε τον Διαχωρισμό Προκαταβολής-Αποκωδικοποίησης

Ο κύριος λόγος για τη χρήση του διαχωρισμού προκαταβολής-αποκωδικοποίησης είναι ότι επιτρέπει την εξειδίκευση μεταξύ των φάσεων προκαταβολής και αποκωδικοποίησης της πρόβλεψης. Η προκαταβολή είναι υπολογιστικά βαριά, και ένα μόνο αίτημα μπορεί να αξιοποιήσει πλήρως την υπολογιστική ισχύ της GPU. Αντίθετα, η αποκωδικοποίηση απαιτεί μεγάλη κίνηση δεδομένων και χρειάζεται μεγάλο αριθμό ταυτόχρονων αιτημάτων για να κορεστεί η υπολογιστική ισχύς στα γραμμικά στρώματα ενός LLM, απαιτώντας έτσι μεγάλο χώρο για την κρυφή μνήμη KV. Με τον διαχωρισμό P/D, μπορούμε να παραλληλίσουμε τις φάσεις προκαταβολής και αποκωδικοποίησης διαφορετικά.

Αξιολόγηση των Ανταλλαγών Απόδοσης

Για να αξιολογήσουμε τις ανταλλαγές απόδοσης μεταξύ συγκεντρωτικών και διαχωρισμένων διαμορφώσεων, σχεδιάζουμε την Απόδοση ανά GPU (TPSG) έναντι της Απόδοσης ανά Χρήστη (TPSU). Το TPSU, μετρημένο σε tokens ανά δευτερόλεπτο ανά χρήστη, αντιπροσωπεύει την αλληλεπίδραση του συστήματος. Το TPSG, μετρημένο σε tokens ανά δευτερόλεπτο ανά GPU, καταγράφει την αποδοτικότητα της υποδομής. Όσο υψηλότερο είναι το TPSG σε κάποιο TPSU, τόσο καλύτερα.

Συμπεράσματα και Εφαρμογές

Αυτή η εργασία δείχνει ότι η διαχωρισμένη εξυπηρέτηση προκαταβολής-αποκωδικοποίησης με το llm-d παρέχει μια συστηματική πορεία για τη βελτιστοποίηση των SLO πρόβλεψης στην υποδομή AMD MI300X. Η ανάλυση Pareto δείχνει ότι στο μεσαίο εύρος αλληλεπίδρασης, οι διαχωρισμένες αρχιτεκτονικές έχουν σταθερά υψηλότερη αποδοτικότητα GPU σε σύγκριση με τις συγκεντρωτικές διαμορφώσεις, μεταφραζόμενη άμεσα σε μειωμένα λειτουργικά κόστη για την εξυπηρέτηση LLM σε επιχειρήσεις. Επιπλέον, το πείραμα κλιμάκωσης επιβεβαιώνει ότι αυτά τα οφέλη επεκτείνονται σε αναπτύξεις πολλαπλών κόμβων, όπου μια διαχωρισμένη διάταξη με λιγότερους κόμβους μπορεί να υπερέχει των συγκεντρωτικών διαμορφώσεων σε υψηλότερους ρυθμούς αιτήσεων, ενώ διατηρεί χαμηλότερη καθυστέρηση P99 μεταξύ των tokens.
  1. https://github.com/llm-d/llm-d
  2. https://rocm.blogs.amd.com/artificial-intelligence/quick-reduce/README.html

Tags: AI NewsAMD

ΣΧΕΤΙΚΑ ΑΡΘΡΑ

Η Databricks φέρνει προγνωστική ανάλυση απευθείας στη SQL
Νέα

Databricks: Predictive AI Functions απευθείας στη SQL

by Kyriakos Koutsourelis
23 Οκτωβρίου, 2026
Η NVIDIA ανοίγει το Run:ai στο οικοσύστημα DSX
Νέα

Η NVIDIA διαθέτει το Run:ai ως open source στο DSX

by Kyriakos Koutsourelis
21 Οκτωβρίου, 2026
StudentSim, η προσέγγιση της Microsoft για καλύτερους AI tutors
Νέα

StudentSim: η έρευνα της Microsoft για καλύτερους AI tutors

by Kyriakos Koutsourelis
20 Οκτωβρίου, 2026
Τι θα κάνει η επόμενη γενιά προγραμματιστών όταν η AI γράφει κώδικα
Νέα

Τι αλλάζει για τους προγραμματιστές όταν η AI γράφει κώδικα

by Kyriakos Koutsourelis
19 Οκτωβρίου, 2026
Γιατί οι τηλεπικοινωνιακοί πάροχοι στρέφονται στα ανοιχτά μοντέλα
Νέα

Τηλεπικοινωνίες και ανοιχτά μοντέλα: η νέα στρατηγική AI

by Kyriakos Koutsourelis
19 Οκτωβρίου, 2026
Η Anthropic εγκαινιάζει το Cyber Mission για την προστασία κρίσιμων υποδομών
Νέα

Anthropic Cyber Mission για την προστασία κρίσιμων υποδομών

by Kyriakos Koutsourelis
18 Οκτωβρίου, 2026
Το AX Practitioner Playbook της Microsoft για agents παραγωγής κώδικα με AI
Νέα

Microsoft AX Playbook για agents παραγωγής κώδικα με AI

by Kyriakos Koutsourelis
17 Οκτωβρίου, 2026
NVIDIA OpenShell: έλεγχοι εκτέλεσης για AI agents
Νέα

NVIDIA OpenShell: ασφαλέστερη λειτουργία για AI agents

by Kyriakos Koutsourelis
15 Οκτωβρίου, 2026
Το NVIDIA DGX Spark 64GB κάνει το local AI πιο προσιτό
Νέα

NVIDIA DGX Spark 64GB για πιο προσιτό local AI

by Kyriakos Koutsourelis
13 Οκτωβρίου, 2026
Next Post
Γιατί η Google καθυστερεί το Gemini 3.5 Pro και ποντάρει στο AI Coding

Γιατί η Google καθυστερεί το Gemini 3.5 Pro και ποντάρει στο AI Coding

Λογότυπο της Anthropic και αναφορά στο νέο Claude Opus 4.8, το αναβαθμισμένο AI μοντέλο για coding, agentic workflows και reasoning.

Claude Opus 4.8: Νέα εργαλεία για agents και developers

Anthropic: Εκρηκτική Ανάπτυξη και Κερδοφορία, αλλά οι Προκλήσεις της AI Αγοράς Παραμένουν

Anthropic: Εκρηκτική Ανάπτυξη και Κερδοφορία, αλλά οι Προκλήσεις της AI Αγοράς Παραμένουν

Πρόσφατα Άρθρα

Η Databricks φέρνει προγνωστική ανάλυση απευθείας στη SQL

Databricks: Predictive AI Functions απευθείας στη SQL

23 Οκτωβρίου, 2026
Πώς το NVIDIA NeMo Gym ενισχύει την αξιοπιστία των AI agents

NVIDIA NeMo Gym: αξιοπιστία AI agents στο chip design

22 Οκτωβρίου, 2026
Η NVIDIA ανοίγει το Run:ai στο οικοσύστημα DSX

Η NVIDIA διαθέτει το Run:ai ως open source στο DSX

21 Οκτωβρίου, 2026

Ετικέτες

Adobe AI Agents AI News AI Tools AI Ρομποτική AI στην καθημερινότητα Alibaba Amazon AMD Anthropic Apple AWS Azure AI Chatbot ChatGPT Claude Copilot Deep Learning Deepmind DeepSeek Gemini GenAI Google Grok Huggingface IBM Intel Llama Machine Learning Meta Microsoft Mistral Nvidia OpenAI Oracle Perplexity Physical AI SAP xAI Εκπαίδευση Επιχειρήσεις Ευρωπαϊκή Ένωση Ηνωμένες Πολιτείες Αμερικής Μέσα Κοινωνικής Δικτύωσης Υγεία

Μενού

  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI
  • Σχετικά με εμάς
  • Βασικές έννοιες
  • Όροι Χρήσης
  • Ιδιωτικότητα

© 2024 Gain - Greek AI Network, all rights reserved.

No Result
View All Result
  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI

© 2024 Gain - Greek AI Network, all rights reserved.