Τεχνητή Νοημοσύνη – Νέα & Εργαλεία | Greek AI Network

Greek AI Network

  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI
No Result
View All Result
Τεχνητή Νοημοσύνη – Νέα & Εργαλεία | Greek AI Network
  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI
No Result
View All Result
Τεχνητή Νοημοσύνη – Νέα & Εργαλεία | Greek AI Network

Greek AI Network

No Result
View All Result
Home Νέα

Reinforcement Learning: Μια Εισαγωγή στη Μάθηση μέσω Ενίσχυσης

by Kyriakos Koutsourelis
15 Φεβρουαρίου, 2025
in Νέα
0
Reinforcement Learning: Μια Εισαγωγή στη Μάθηση μέσω Ενίσχυσης
Share on FacebookShare on Twitter

Η Μάθηση μέσω Ενίσχυσης (Reinforcement Learning – RL) είναι ένας από τους τρεις βασικούς τύπους μηχανικής μάθησης, μαζί με τη Μάθηση υπό Επίβλεψη (Supervised Learning) και τη Μάθηση χωρίς Επίβλεψη (Unsupervised Learning). Πρόκειται για μια μεθοδολογία εκπαίδευσης ενός πράκτορα (agent) μέσω δοκιμών και λαθών, με στόχο τη βελτιστοποίηση της συμπεριφοράς του μέσα σε ένα περιβάλλον (environment).

Σε αυτό το άρθρο, θα αναλύσουμε τα βασικά στοιχεία του Reinforcement Learning, πώς λειτουργεί, δημοφιλείς αλγορίθμους, και τις πρακτικές εφαρμογές του.


1. Τι είναι η Μάθηση μέσω Ενίσχυσης;

Η Μάθηση μέσω Ενίσχυσης βασίζεται στην ιδέα της ενίσχυσης επιθυμητών συμπεριφορών μέσω ανταμοιβών (rewards) και της αποθάρρυνσης ανεπιθύμητων ενεργειών μέσω ποινών (penalties).

1.1 Στοιχεία ενός συστήματος Reinforcement Learning

Ένα σύστημα RL αποτελείται από τα εξής βασικά στοιχεία:

  • Πράκτορας (Agent): Ο μαθησιακός μηχανισμός που λαμβάνει αποφάσεις.
  • Περιβάλλον (Environment): Ο κόσμος στον οποίο λειτουργεί ο πράκτορας.
  • Κατάσταση (State – S): Η παρούσα κατάσταση του περιβάλλοντος.
  • Δράση (Action – A): Η ενέργεια που επιλέγει ο πράκτορας.
  • Ανταμοιβή (Reward – R): Η ανάδραση που λαμβάνει ο πράκτορας μετά από μια ενέργεια.
  • Πολιτική (Policy – π): Η στρατηγική που ακολουθεί ο πράκτορας για να επιλέγει ενέργειες.
  • Συνάρτηση Αξίας (Value Function – V): Εκτιμά τη μελλοντική ανταμοιβή από μια κατάσταση.
  • Συνάρτηση Q-Value (Q-function – Q): Προβλέπει την αξία μιας συγκεκριμένης ενέργειας σε μια δεδομένη κατάσταση.

2. Πώς λειτουργεί το Reinforcement Learning;

Η μάθηση πραγματοποιείται μέσω αλληλεπιδράσεων του πράκτορα με το περιβάλλον. Ο πράκτορας λαμβάνει μια κατάσταση, επιλέγει μια δράση, λαμβάνει μια ανταμοιβή και ενημερώνει τη στρατηγική του ώστε να μεγιστοποιήσει τις μελλοντικές ανταμοιβές.

2.1 Διαδικασία Μάθησης μέσω Ενίσχυσης

  1. Ο πράκτορας παρατηρεί την τρέχουσα κατάσταση του περιβάλλοντος.
  2. Επιλέγει μια ενέργεια βάσει της πολιτικής του.
  3. Το περιβάλλον ανταποκρίνεται και μεταβαίνει σε μια νέα κατάσταση.
  4. Ο πράκτορας λαμβάνει μια ανταμοιβή.
  5. Ενημερώνει τη στρατηγική του με βάση την εμπειρία του.
  6. Η διαδικασία συνεχίζεται έως ότου ο πράκτορας μάθει τη βέλτιστη πολιτική.

Η διαδικασία αυτή βασίζεται στη θεωρία των Μαρκοβιανών Διαδικασιών Απόφασης (Markov Decision Processes – MDPs), που μοντελοποιούν τις δυναμικές ενός συστήματος RL.


3. Δημοφιλείς Αλγόριθμοι Reinforcement Learning

Υπάρχουν διάφοροι αλγόριθμοι RL, οι οποίοι χωρίζονται σε τρεις κύριες κατηγορίες:

3.1 Αλγόριθμοι Βασισμένοι σε Πολιτικές (Policy-based)

  • REINFORCE: Ένας βασικός αλγόριθμος που χρησιμοποιεί τη μέθοδο Gradient Ascent για να βελτιστοποιήσει την πολιτική.
  • Actor-Critic: Συνδυάζει έναν πράκτορα (Actor) που παίρνει αποφάσεις και έναν κριτή (Critic) που αξιολογεί τις αποφάσεις.

3.2 Αλγόριθμοι Βασισμένοι σε Τιμές (Value-based)

  • Q-learning: Ένας δημοφιλής αλγόριθμος εκτός πολιτικής (off-policy) που χρησιμοποιεί τον πίνακα Q για να μάθει την καλύτερη δράση σε κάθε κατάσταση.
  • Deep Q-Networks (DQN): Μια εκδοχή του Q-learning που χρησιμοποιεί νευρωνικά δίκτυα για πιο πολύπλοκες καταστάσεις.

3.3 Υβριδικοί Αλγόριθμοι (Model-free & Model-based)

  • Proximal Policy Optimization (PPO): Ισορροπεί μεταξύ εύρεσης νέων πολιτικών και εκμετάλλευσης των υπαρχουσών.
  • Trust Region Policy Optimization (TRPO): Περιορίζει τις αλλαγές στην πολιτική για να διατηρήσει τη σταθερότητα.

4. Πρακτικές Εφαρμογές του Reinforcement Learning

Το Reinforcement Learning έχει ευρεία εφαρμογή σε διάφορους τομείς, όπως:

4.1 Ρομποτική

  • Οι ρομποτικοί βραχίονες χρησιμοποιούν RL για να μάθουν να εκτελούν εργασίες όπως η συναρμολόγηση εξαρτημάτων.

4.2 Αυτόνομα Οχήματα

  • Τα αυτόνομα οχήματα χρησιμοποιούν RL για να λαμβάνουν αποφάσεις πλοήγησης και αποφυγής εμποδίων.

4.3 Παιχνίδια & AI Agents

  • Το AlphaGo της DeepMind, που νίκησε κορυφαίους παίκτες στο Go, βασίζεται στο RL.

4.4 Χρηματοοικονομικές Αγορές

  • Οι αλγόριθμοι RL μπορούν να αναλύουν την αγορά και να εκτελούν συναλλαγές με στόχο τη μεγιστοποίηση του κέρδους.

4.5 Υγεία & Ιατρική

  • Το RL βοηθά στη δημιουργία εξατομικευμένων θεραπευτικών πρωτοκόλλων.

5. Προκλήσεις & Μελλοντικές Εξελίξεις

Παρά τα εντυπωσιακά επιτεύγματα του RL, υπάρχουν σημαντικές προκλήσεις, όπως:

  • Υπολογιστική Πολυπλοκότητα: Οι αλγόριθμοι RL απαιτούν τεράστιους πόρους υπολογιστικής ισχύος.
  • Δυσκολία στην Ερμηνεία: Οι αποφάσεις των πρακτόρων RL είναι δύσκολο να εξηγηθούν.
  • Αποδοτικότητα Μάθησης: Οι αλγόριθμοι απαιτούν μεγάλο αριθμό δεδομένων για να εκπαιδευτούν.

Μελλοντικές εξελίξεις στο RL περιλαμβάνουν:

  • Συνδυασμό με μηχανισμούς Meta-Learning για την επιτάχυνση της μάθησης.
  • Χρήση RL για την ανάπτυξη πιο “ανθρώπινων” ΑΙ πρακτόρων.

Συμπέρασμα

Το Reinforcement Learning είναι ένας από τους πιο ισχυρούς και καινοτόμους τομείς της τεχνητής νοημοσύνης. Από τα παιχνίδια μέχρι την ιατρική, το RL έχει τη δυνατότητα να μεταμορφώσει τη σύγχρονη τεχνολογία. Παρότι αντιμετωπίζει προκλήσεις, η συνεχής έρευνα υπόσχεται σημαντικές βελτιώσεις και νέα συναρπαστικά επιτεύγματα.

Αν ενδιαφέρεστε να μάθετε περισσότερα, μπορείτε να πειραματιστείτε με δημοφιλή εργαλεία όπως το OpenAI Gym και το Stable-Baselines3! 🚀
Tags: AI News

ΣΧΕΤΙΚΑ ΑΡΘΡΑ

Multi-agent συστήματα τεχνητής νοημοσύνης αυτοματοποιούν λειτουργίες logistics, διαχείρισης αποθεμάτων και εφοδιαστικής αλυσίδας.
Νέα

AI agents στις εφοδιαστικές αλυσίδες

by Theodoros Kostogiannis
22 Σεπτεμβρίου, 2026
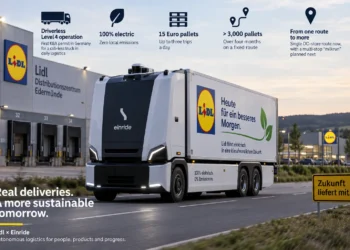
Η Lidl δοκιμάζει στη Γερμανία το μέλλον των εμπορευματικών μεταφορών, εντάσσοντας στις καθημερινές παραδόσεις της ένα ηλεκτρικό, αυτόνομο φορτηγό Level 4 της Einride. Το όχημα κινείται σε δημόσιους δρόμους χωρίς οδηγό ή χειριστή ασφαλείας στην καμπίνα και μπορεί να πραγματοποιεί έως τρία δρομολόγια την ημέρα. Το πιλοτικό πρόγραμμα θα διαρκέσει τέσσερις μήνες και θα βοηθήσει τη Lidl να αξιολογήσει κατά πόσο η αυτόνομη οδήγηση μπορεί να ενσωματωθεί σε μεγαλύτερη κλίμακα στο δίκτυο logistics της.
Νέα

Η Lidl βάζει αυτόνομο φορτηγό στις παραδόσεις στη Γερμανία

by Theodoros Kostogiannis
21 Σεπτεμβρίου, 2026
Η TypeSafe AI βγαίνει από τη φάση stealth και παρουσιάζει το Jev, ένα νέο μοντέλο τεχνητής νοημοσύνης που έχει σχεδιαστεί όχι για συνομιλίες, αλλά για γρήγορη και δομημένη λήψη αποφάσεων μέσα σε εφαρμογές λογισμικού. Πίσω από την εταιρεία βρίσκεται ο Diogo Almeida, πρώην στέλεχος της OpenAI και ένας από τους συνδημιουργούς του ChatGPT. Η ομάδα της TypeSafe εργάστηκε για περίπου δύο χρόνια πάνω στο Jev, επιχειρώντας να αντιμετωπίσει ορισμένους από τους περιορισμούς που εμφανίζουν τα παραδοσιακά Large Language Models όταν χρησιμοποιούνται για αυτοματοποίηση.
Νέα

Η TypeSafe λανσάρει το Jev για προγραμματιστική λογική

by Theodoros Kostogiannis
18 Σεπτεμβρίου, 2026
Η Pony.ai αποκάλυψε τη νέα γενιά του αυτόνομου ηλεκτρικού της φορτηγού, ενισχύοντας την παρουσία της στον τομέα των εμπορευματικών μεταφορών χωρίς οδηγό. Το T9 Robotruck, που αναπτύχθηκε από κοινού με την GAC Commercial Vehicle, υποστηρίζει αυτόνομη οδήγηση Level 4 και προορίζεται κυρίως για μεταφορές μεγάλων αποστάσεων και εφαρμογές logistics.
Νέα

Η Pony.ai παρουσιάζει αυτόνομο ηλεκτρικό φορτηγό για logistics

by Theodoros Kostogiannis
17 Σεπτεμβρίου, 2026
Η AI αναδιαμορφώνει την αγορά εργασίας στην Ιρλανδία
Νέα

AI και εργασία στην Ιρλανδία: τι δείχνει νέα έρευνα

by Kyriakos Koutsourelis
17 Σεπτεμβρίου, 2026
Google: Επένδυση 13 δισ. ευρώ στη Φινλανδία για AI data centers και ενέργεια
Νέα

Google: Επένδυση 13 δισ. ευρώ στη Φινλανδία για AI data centers και ενέργεια

by Kyriakos Koutsourelis
16 Σεπτεμβρίου, 2026
Η Microsoft AI επιχειρεί να θέσει σαφή όρια στο πόση αυτονομία μπορούν να αποκτήσουν τα προηγμένα συστήματα τεχνητής νοημοσύνης, παρουσιάζοντας το προσχέδιο του Humanist AI Code of Conduct. Το νέο πλαίσιο περιγράφει τους κανόνες που θα πρέπει να ακολουθούν τα μοντέλα AI της εταιρείας κατά την εκπαίδευση και τη λειτουργία τους. Κεντρική αρχή είναι ότι ο άνθρωπος πρέπει να διατηρεί πάντοτε τον τελικό έλεγχο. Ένα μοντέλο θα πρέπει ακόμη και να αποτυγχάνει στην εκτέλεση μιας εργασίας, εφόσον η ολοκλήρωσή της προϋποθέτει ουσιαστική παραβίαση των κανόνων ασφαλείας.
Νέα

Η Microsoft βάζει «κόκκινες γραμμές» στην αυτονομία της AI

by Theodoros Kostogiannis
15 Σεπτεμβρίου, 2026
Το άρθρο εξετάζει την αυξανόμενη ανησυχία γύρω από την ταχύτατη ανάπτυξη της Τεχνητής Νοημοσύνης (AI) και τις εκκλήσεις κορυφαίων στελεχών του κλάδου για επιβράδυνση. Προσωπικότητες όπως οι Dario Amodei (Anthropic), Sam Altman (OpenAI) και Elon Musk εκφράζουν προβληματισμό για τους πιθανούς κινδύνους των ολοένα ισχυρότερων μοντέλων AI.
Νέα

Οι ηγέτες της AI ζητούν επιβράδυνση, αλλά ποιος θα κάνει την αρχή;

by Theodoros Kostogiannis
14 Σεπτεμβρίου, 2026
Νέο εθνικό πρότυπο για την ασφαλή χρήση της AI στα σχολεία
Νέα

AI στα σχολεία: νέο πρότυπο για ασφάλεια και ιδιωτικότητα

by Kyriakos Koutsourelis
14 Σεπτεμβρίου, 2026
Next Post
Η Τεχνητή Νοημοσύνη και το Μέλλον της Κινητικότητας

Η Τεχνητή Νοημοσύνη και το Μέλλον της Κινητικότητας

Οι τεχνολογικοί γίγαντες ξεκινούν μια άνευ προηγουμένου δαπάνη 320 δισεκατομμυρίων δολαρίων για υποδομές AI το 2025, παραμερίζοντας τις ανησυχίες για πιο αποδοτικά μοντέλα AI από διεκδικητές όπως η DeepSeek. Η μαζική ώθηση των επενδύσεων από την Amazon, τη Microsoft, τη Google και τη Meta σηματοδοτεί την ακλόνητη πεποίθηση των μεγάλων παικτών ότι το μέλλον της AI απαιτεί τολμηρά στοιχήματα σε υποδομές, παρά (ή ίσως εξαιτίας) των αναδυόμενων επιτευγμάτων αποδοτικότητας. Το διακύβευμα είναι υψηλό, με τις συλλογικές κεφαλαιουχικές δαπάνες να εκτοξεύονται κατά 30% από την επένδυση των 246 δισεκατομμυρίων δολαρίων του 2024. Ενώ οι επενδυτές μπορεί να αμφισβητούν την αναγκαιότητα τέτοιων επιθετικών δαπανών, οι ηγέτες της τεχνολογίας διπλασιάζουν την πεποίθησή τους ότι η Τεχνητή Νοημοσύνη αποτελεί μια μετασχηματιστική ευκαιρία που αξίζει κάθε δολάριο.

Δαπάνη $320B για τις Big tech που αψηφούν τον αγώνα αποδοτικότητας

Ενσωματώστε το DeepSeek R1 εύκολα μέσω Azure AI

Ενσωματώστε το DeepSeek R1 εύκολα μέσω Azure AI

Πρόσφατα Άρθρα

Multi-agent συστήματα τεχνητής νοημοσύνης αυτοματοποιούν λειτουργίες logistics, διαχείρισης αποθεμάτων και εφοδιαστικής αλυσίδας.

AI agents στις εφοδιαστικές αλυσίδες

22 Σεπτεμβρίου, 2026
Η NVIDIA στο επίκεντρο της παγκόσμιας αγοράς των robotaxi

NVIDIA και robotaxi: η πλατφόρμα πίσω από την κλιμάκωση

22 Σεπτεμβρίου, 2026
Η Lidl δοκιμάζει στη Γερμανία το μέλλον των εμπορευματικών μεταφορών, εντάσσοντας στις καθημερινές παραδόσεις της ένα ηλεκτρικό, αυτόνομο φορτηγό Level 4 της Einride. Το όχημα κινείται σε δημόσιους δρόμους χωρίς οδηγό ή χειριστή ασφαλείας στην καμπίνα και μπορεί να πραγματοποιεί έως τρία δρομολόγια την ημέρα. Το πιλοτικό πρόγραμμα θα διαρκέσει τέσσερις μήνες και θα βοηθήσει τη Lidl να αξιολογήσει κατά πόσο η αυτόνομη οδήγηση μπορεί να ενσωματωθεί σε μεγαλύτερη κλίμακα στο δίκτυο logistics της.

Η Lidl βάζει αυτόνομο φορτηγό στις παραδόσεις στη Γερμανία

21 Σεπτεμβρίου, 2026

Ετικέτες

Adobe AI Agents AI News AI Tools AI Ρομποτική AI στην καθημερινότητα Alibaba Amazon AMD Anthropic Apple AWS Azure AI Chatbot ChatGPT Claude Copilot Deepmind DeepSeek Gemini GenAI Google Grok Huggingface IBM Intel Llama Machine Learning Meta Microsoft Mistral Nvidia OpenAI Oracle Perplexity Physical AI Salesforce Samsung xAI Εκπαίδευση Επιχειρήσεις Ευρωπαϊκή Ένωση Ηνωμένες Πολιτείες Αμερικής Μέσα Κοινωνικής Δικτύωσης Υγεία

Μενού

  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI
  • Σχετικά με εμάς
  • Βασικές έννοιες
  • Όροι Χρήσης
  • Ιδιωτικότητα

© 2024 Gain - Greek AI Network, all rights reserved.

No Result
View All Result
  • Αρχική
  • Νέα
  • Εργαλεία AI
    • Για Βίντεο
    • Για Εικόνα
    • Για Εκπαιδευτικούς
    • Για Εξειδικευμένες Εφαρμογές
    • Για Ήχο
    • Για Κείμενο
  • Εφαρμογές AI
  • Βασικές έννοιες
  • Εκπαιδευτικά Προγράμματα
    • Δωρεάν σεμινάρια AI
    • Κατάρτηση AI

© 2024 Gain - Greek AI Network, all rights reserved.